
- 光半導体関連
NEW
光電融合はどこで使われる?AIインフラを支えるScale Across・Scale Out・Scale Up・Scale In

目次
なぜ今、光電融合が必要なのか
生成AIの急速な普及にともない、データセンターが扱う通信量と計算量は爆発的に増えています。膨大な数のGPUが絶えずデータをやり取りするようになり、消費電力と発熱の増加が課題となっています。処理性能を高めるには、GPU間をより高速・大容量につなぐ必要があります。
この課題を解決する鍵として注目されているのが「光電融合」です。光電融合とは、光通信の適用領域を広げるために、電子回路と光回路・光デバイスを近接または一体化し、電気と光のそれぞれの特長を生かして、高速・大容量・低消費電力の情報処理や通信を実現する技術です。
特にデータセンターでは、スイッチASIC(ネットワーク機器でデータの転送処理を担う専用半導体)やGPUなどの半導体と光電変換部の間にある高速電気配線を短くし、信号損失や消費電力を抑える取り組みが進められています。電気信号は伝送距離が長くなり、通信速度が高くなるほど、信号損失や消費電力が増えやすくなります。そこで、信号を光に置き換え、電気配線の距離を短くする考え方が注目されています。
電気配線の距離を短くすることで、消費電力や信号の劣化を抑えやすくなります。だからこそ、光への変換点を通信の相手側だけでなく、できるだけ半導体チップの近くへ寄せていくことが効果的になります。こうして光通信の適用領域は段階的に広がっていきます。ただし一度にすべてを光化できるわけではなく、光でつなぐ対象を、データセンター間という“外側”から半導体のパッケージ内部という“内側”へと進めていくことになります。
接続する距離とシステム上の役割から光電融合を見る
AIインフラの接続は、どのくらいの距離を、何と何で接続するのか、また、接続した機器をどのように連携させるのかという視点から整理できます。たとえば、複数のGPUを一つの大きな計算システムとして動かす接続と、複数のサーバーをつないで計算できる範囲を広げる接続では、求められる通信速度や遅延、接続方法が異なります。
そこで本記事では、Scale Across・Scale Out・Scale Up・Scale Inについて、接続する距離や対象、システムの中での役割を見ていきます。
接続範囲は、チップやパッケージの内部から、複数のGPU間、データセンター内のサーバーやラック間、さらに複数のデータセンター間まで広がります。一般にScale InからScale Acrossへ向かうほど接続距離は長くなりますが、接続する対象やシステムの中での役割によって、それぞれに求められる技術は異なります。(参照:https://www.marvell.com/solutions/data-center/scaling-ai-infrastructure.html)
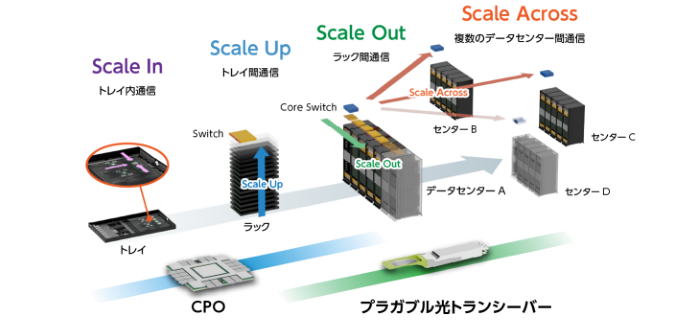
Scale Across:複数のデータセンターや地域をつなぐ
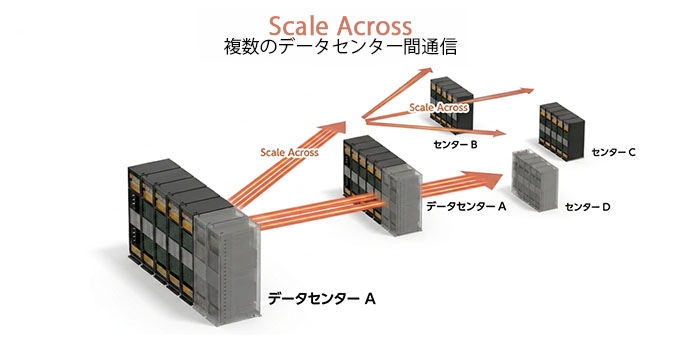
Scale Acrossは、単一のデータセンターや施設の枠を超えて、複数の拠点に分散したAIクラスター(複数のGPUやサーバーを連携させた計算システム)をつなぎ、全体を一つのデータセンターのように連携して稼働させる考え方です。データセンターの分散・相互接続(DCI:Data Center Interconnect)の拡大が見込まれる領域であり、接続する距離によって、次の二つに分けられます。
Campus Scale Across
同じキャンパス内や比較的近い場所にある複数のデータセンター間の接続を指します。
Long-haul Scale Across
都市圏や地域をまたぐ、より長距離のデータセンター間の接続を指します。
どちらの場合も、複数拠点の計算設備を一体的に利用するため、高速・大容量かつ低遅延な接続が求められます。こうした接続には、距離や用途に応じたプラガブル光トランシーバーの活用が想定されます。
光トランシーバーは、ネットワーク機器から受け取った電気信号を光信号へ変換して送信し、受信した光信号を電気信号へ戻す通信モジュールです。着脱可能なプラガブル光トランシーバーは、データセンター間だけでなく、データセンター内のラック間やスイッチ間など、さまざまな接続に使われています。プラガブル光トランシーバーは、現在はデータセンター内のScale Outネットワークを中心に広く使われています。Scale Acrossの拠点間接続でも、距離や用途に応じた活用が想定されます。

光トランシーバーの仕組みや最新の動向については、こちらの記事で詳しく解説しています。あわせてご覧ください。 光トランシーバーの基礎知識と最新動向
こうした高速化にともなう課題に対して、デクセリアルズがどのような製品で応えられるかは、別記事「Scale Acrossの光トランシーバー向け製品紹介」で紹介します。
Scale Out:サーバーやラックを増やし、計算できる範囲を広げる
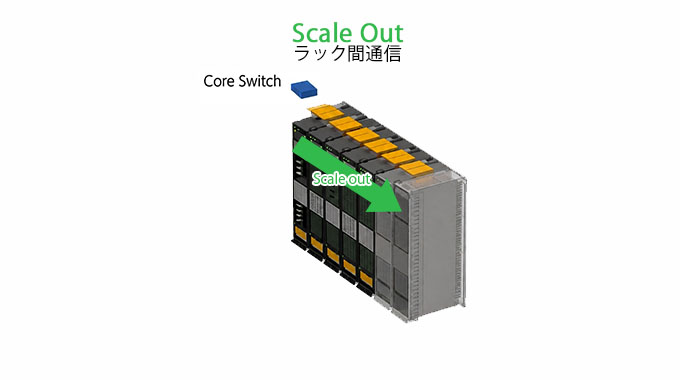
Scale Outは、複数のサーバーや、Scale Upで構成された計算システムをネットワークでつなぎ、データセンター内で計算できる範囲を広げる考え方です。処理を複数のサーバーに分けるため、大量のデータを効率よく送るための通信容量と、通信の遅れを抑える仕組みが求められます。
Scale Outでは、サーバーやラック間の接続にプラガブル光トランシーバーが広く使われています。一方、接続する機器や通信容量が増えると、スイッチASICと前面の光トランシーバーを結ぶ電気配線が長くなり、信号損失や消費電力が増えやすくなります。そこで、電気配線を短くするため、光への変換点をスイッチASICの近くに配置する技術が開発されています。その一つが、スイッチASICと光エンジンを同じパッケージに収めるCPO(Co-Packaged Optics)です。CPOでは、電気信号と光信号を変換する光エンジンをスイッチASICの近くに配置することで、高速な電気信号が通る距離を短くできます。これは、これまで電気配線が中心だった短距離領域へ光通信の適用が広がることを意味し、今後はCPOネットワークスイッチの普及が見込まれています。(The New Optical Interface: Novel Connector Designs and Intelligent Alignments Enable the CPO Era | Features | Feb 2026 | Photonics Spectra)
CPOを採用した製品の開発も進んでいます。BroadcomはスイッチASICと光エンジンを一体化した102.4Tb/s対応の「Tomahawk 6-Davisson」を発表しています。(Broadcom Announces Tomahawk® 6 – Davisson, the Industry’s First 102.4-Tbps Ethernet Switch with Co-Packaged Optics)また、NVIDIAは、CPOを採用した「Spectrum-X Ethernet Photonics」と「Quantum-X InfiniBand Photonics」を発表しています。(Silicon Photonics Networking for Agentic AI | NVIDIA)。 Scale Outでどのような部材が関わり、デクセリアルズがどのような技術を提案できるかは、今後の個別記事で取り上げる予定です。
Scale Up:複数のGPUをつなぎ、一つの大きな計算システムとして動かす
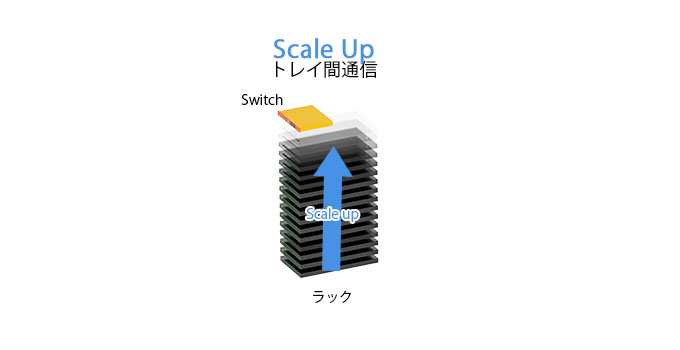
Scale Upは、複数のGPUやXPU(GPUなどを含む演算用半導体の呼称)、メモリなどを高速につなぎ、一つの大きな計算システムとして動かす考え方です。接続範囲は、1台のサーバーの内部だけでなく、ラック内や複数のラックに広がる場合もあります。
現在は銅を使った電気配線が広く使われていますが、AIの規模拡大に伴って一度に送る必要があるデータ量が増え、消費電力に対する要求も厳しくなり、銅配線だけで通信距離や速度を伸ばし続けることが難しくなっています。そこで、電気配線の距離を短くし、光を使ってデータをやり取りする技術の開発が進んでいます。
将来の構成の一つとして、光信号をつくる光エンジンをGPU/XPUのパッケージ近くに配置し、GPU/XPU間を光で接続する方法が検討されています。これにより、GPU/XPU間の高速な電気配線を短縮し、光による接続を実現する構成が目指されています。
Scale Upへの光インターコネクト(光を使って機器や半導体を接続する技術)導入に向けた開発も進んでいます。MarvellはAIクラスター向けに200Gbpsの電気・光インターフェースを備えた3Dシリコンフォトニクス光エンジンを公開しています。(Marvell Demonstrates Industry’s First 200G 3D Silicon Photonics Engine to Scale Accelerated Infrastructure)。また、NVIDIAは、複数のGPUやカスタム半導体を接続する「NVLink Fusion」を発表しており、MediaTekなどが参画しています。(MediaTek | NVLink Fusion | Custom AI ASIC Innovation)Scale Upで関わる部材やデクセリアルズの提案余地は、今後の個別記事で取り上げる予定です。
Scale In:チップやパッケージの内部で処理性能を高める
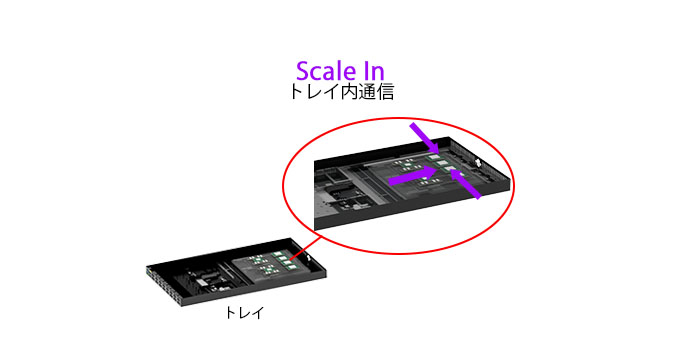
Scale Inは、チップやパッケージ、1台の計算機器の内部で、処理性能や電力効率を高める考え方です。GPU、HBM(High Bandwidth Memory:GPUの近くに配置される広帯域メモリ)、チップレット(機能ごとに分割した小型の半導体チップ)などを短い距離で高密度につなぎ、データを高速にやり取りできるようにします。
現在は電気配線が中心ですが、通信容量の増加や消費電力の低減に向けて、Die間やチップレット間に光I/O(光信号によるデータの入出力)を取り入れる研究も進められています。Die(ダイ:半導体ウエハーから切り出した個々のチップ)を高密度に積んだり並べたりするほど、Dieの近くでも電気配線の混雑、信号損失、発熱が課題になります。そのため、パッケージの内部まで光を取り入れる技術が検討されています。その方法の一つが、チップを載せる土台である基板(インターポーザ)に光の通り道を設け、その中で光信号を伝える構成です。こうした光配線を組み込んだ基板は「Photonic Interposer(フォトニック・インターポーザ)」と呼ばれ、シリコンやガラスなど、さまざまな材料を用いる構成が研究されています。
Scale Inに光I/Oを取り入れる技術は、現在も研究・試作が中心で、広く量産される時期は明確になっていません(2026年7月時点)。
Intelは、光I/OチップレットをCPUと同じパッケージに実装し、実際にデータを伝送する試作システムを公開しています。将来は、CPUやGPUなどと同じパッケージに組み込み、電気信号と光信号を変換する光I/O技術としての活用が想定されています。(Intel Demonstrates First Fully Integrated Optical I/O Chiplet – Intel Newsroom)Scale Inで関わる部材やデクセリアルズの提案余地は、今後の個別記事で取り上げる予定です。
まとめ:接続する距離と役割から光電融合を捉える
ここまで見てきたように、AIインフラの接続は、チップやパッケージの内部で処理性能を高めるScale In、複数のGPUを一つの大きな計算システムとして動かすScale Up、サーバーやラックを増やして計算できる範囲を広げるScale Out、複数のデータセンターや地域をつなぐScale Acrossという視点から整理できます。それぞれは、接続する距離や対象、システムの中での役割が異なります。また、一つずつ順番に置き換わるものではなく、AIインフラの構成や用途に応じて組み合わせて使われます。
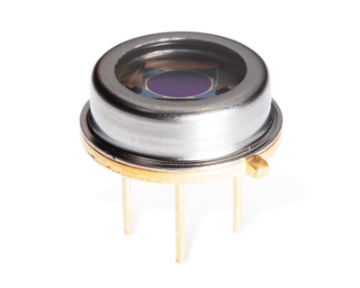
現在、光トランシーバーはデータセンター内のScale Outを中心に広く使われており、今後はScale Acrossでの活用も広がると見込まれます。Scale UpやScale Inでは電気接続が中心ですが、通信容量の増加、低遅延化、消費電力の低減に向けて、光インターコネクトや光I/Oを導入する技術開発が進んでいます。技術開発の進展に伴い、光の接続点はよりチップに近い位置へ移っていくと考えられます。光通信が使われる範囲が広がり、光の接続点がチップに近づくほど、光を低損失につなぐ光結合技術、異なる材料・デバイスを高精度に接合する異種接合・集積技術、多層化・高密度化を支える高密度実装技術といった実装面の課題も変化します。デクセリアルズでは、光を電気に変えるフォトダイオード(高速応答フォトダイオード(PD))や光出力を監視・制御するモニターPDだけでなく、部品を精密に固定する工業用接着剤、微細な電気接続を担う異方性導電膜(ACF)、光の向きや量を制御する無機光学素子、また新たな製品開発を通じて、こうした課題の解決に取り組んでいます。その背景には、電気配線の距離を短くし、信号損失や消費電力を抑えるという共通の考え方があります。
注目が高まる光電融合の分野で、デクセリアルズはこれからも、エンジニアの皆さまが直面する課題の解決に貢献できる技術を追求してまいります。
関連記事

私たちデクセリアルズはデバイスの進化に欠かせない材料や次世代のソリューションを生み出す、マテリアルメーカーです。
電子部品、接合材料、光学材料をはじめと世界中のパートナーと新しい価値を生み出していきます。
- SHARE
当社の製品や製造技術に関する資料をご用意しています。
無料でお気軽にダウンロードいただけます。
お役立ち資料のダウンロードはこちら関連製品

関連記事
光半導体関連の人気記事

当社の製品や製造技術に関する資料をご用意しています。
無料でお気軽にダウンロードいただけます。
お役立ち資料のダウンロードはこちら